Mostrando entradas con la etiqueta Informática. Mostrar todas las entradas

martes, 4 de febrero de 2014

Los MOOC

Una sigla que está muy de moda en internet...

¿Qué son los MOOC?


Los MOOC, siglas inglesas de Massive Open Online Course ('Cursos en Línea Masivos y Abiertos) son, como su nombre indica, unos cursos a los que cualquiera, en cualquier momento y con cualquier formación (incluso ninguna), puede acceder, en la mayoría de los casos, sin tener que pagar.

Con la que está cayendo, está claro que esto es una estupenda alternativa para aquellos que no puedan pagarse estudios o simplemente para aquellos a los que les apetezca aprender algo que, en principio, no tiene nada que ver con su formación.

¿Qué MOOC existen en la actualidad?

Ese fue mi caso, de hecho: el primer curso que hice fue uno de Introducción a las ciencias de la informática, organizado por Udacity, en el que se enseñaba, fundamentalmente, a programar utilizando el lenguaje Python. Hasta entonces, era un lenguaje de programación totalmente desconocido para mí pero ahora, aunque no me he convertido en una programadora, tengo las suficientes nociones como para saber defenderme.
"Introduction to Computer Science": ese es el curso que hice.
De hecho, Udacity es una de las plataformas MOOC más importantes y conocidas. Sin embargo, hay otras muchas, claro. Otra plataforma que descubrí un poco más tarde fue Coursera, que organiza cursos mucho más variados:

Captura de pantalla de Coursera.
En Coursera intenté hacer un curso de lenguaje computacional, si no recuerdo mal, pero fue demasiado difícil para mí...

Pero... ¿qué pasa si no sabemos inglés? Pues hay muchas más ofertas, desde luego. Las que más me han llamado la atención son dos, UNED COMA ("COMA" responde a las siglas de Cursos Online Masivos y Abiertos) y MiríadaX. El año pasado hice un curso de alemán para hispanohablantes y uno de inglés profesional mediante UNED COMA, que me gustó muchísimo, y ahora estoy haciendo uno de Introducción al desarrollo de videojuegos en Miríada X, que también me está pareciendo muy interesante.

Sin embargo, esto no acaba aquí: ¡hay muchísimas más páginas webs donde puedes encontrar cursos en línea abiertos! Sin ir más lejos, hace unos días terminé un curso de introducción a la gestión de proyectos en Open2Study, del que hablaré en otra entrada, porque creo que tiene interés de cara a la traducción. Y para terminar, también hay una plataforma que ofrece muchos cursos interesantes en francés: se trata de FUN (siglas de France Université Numérique, Francia Universidad Digital, literalmente). Todavía no he hecho ningún curso en esta plataforma, a pesar de que vi alguno interesante, porque tampoco quería saturarme con cursos.

Entonces, ¿los MOOC sirven para algo?

En definitiva, este tipo de cursos son muy útiles por varias razones. En primer lugar, te viene bien para el currículum (aunque la mayoría de certificados, si es que los expiden, no tienen la validez oficial de un título, pero ahí están); en segundo lugar, sigues formándote y, en el caso de que no estés haciendo nada, te viene bien para no quedarte parado (en ambos sentidos, desgraciadamente). En tercer lugar, si estás haciendo un curso en una lengua que no es tu lengua materna, te viene bien para practicar y mejorar dicha lengua y, en cuarto y último lugar, ¡siempre aprendes algo nuevo! Solo hace falta algo de constancia, dado que son cursos que hacemos porque queremos: nadie nos obliga a hacerlos, y es por eso que resultan tan interesantes.

Algunas plataformas también ofrecen medallas, a la manera de los logros de los
videojuegos... Aquí tenéis algunas de las medallitas que he obtenido en Open2Study.

domingo, 17 de junio de 2012

Otras herramientas de traducción asistida por ordenador

A pesar de que la asignatura ya llegó a su fin y de que también ha llegado a su fin la licenciatura, no quiero dejar de lado este blog, pues le he dedicado mucho tiempo y, además, creo que todavía hay muchas cosas relacionadas con la informática aplicada a la traducción que desconozco.

De esta forma, estos últimos días he estado investigando un poco por internet y he encontrado una serie de programas de traducción automática y de traducción asistida por ordenador, que he instalado y probado en mi ordenador. Dado que los primeros no tienen mucho misterio (solo hay que insertar el texto origen y el programa traduce de forma automática), solo los mencionaré y me centraré un poco más en los segundos.

En cuanto a los programas de traducción automática, podríamos mencionar, además de Systran (del que ya hablé brevemente en esta entrada), English-Spanish Interpreter Standard 4.4, que tiene en cuenta el contexto para hacer mejores traducciones (el contexto resulta más importante de lo que parece, pues es lo que le permite al programa decidirse por una o por otra traducción de una determinada palabra que admita varias opciones de traducción) o MultiTranse. Sin embargo, como ya he dicho, su manejo no es especialmente difícil y, además, son todos más o menos iguales en cuanto a su funcionamiento.

Ahora bien, hay que tener en cuenta que existen muchos programas de memorias de traducción o de traducción asistida, además de Trados (que, desgraciadamente, todavía no he tenido la ocasión de probar, a pesar de que cada vez son más las empresas que consideran un requisito indispensable que sus traductores sepan utilizarlo), Déjà Vu u OmegaT. Así, algunos de los programas que he estado analizando estos días son MetaTexis for Word, WebBudget XT y Wordfast.

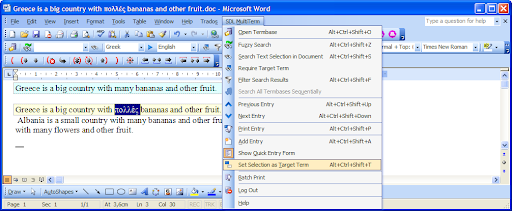
Metatexis for Word me ha parecido muy interesante y muy útil, dado que consiste en un sistema de memoria de traducción integrado en Word, es decir, es como una memoria más de traducción pero con la diferencia de que se trabaja en Word, lo que tiene la ventaja de que son muchas las posibilidades de explotación de los textos, por lo que no tiene las limitaciones que pueden tener otras herramientas del estilo en cuanto a la edición de los textos (que suele ser más simple).

Para que quede más claro, ofrezco una captura de pantalla del entorno de trabajo de este programa:

Captura de pantalla del entorno de trabajo con Metatexis for Word.
Extraído de http://www.translatum.gr/forum/index.php?topic=417.0
[Consulta: 17/VI/2012]  
Aunque la imagen es pequeña, sí puede verse cómo el programa forma parte de la interfaz de Word, ya que es una pestaña más, como pueden ser Archivo o Formato, por ejemplo. Dejando de lado el hecho de que se integra en Word, funciona como cualquier programa de memoria de traducción: el texto se divide en segmentos y para pasar de un segmento a otro solo hay que utilizar la combinación de teclas Alt + abajo.

WebBudget XT ha sido el segundo programa que me ha llamado la atención. Aunque su uso resulta más complicado, una vez que se aprende a manejarlo resulta muy útil para la traducción de páginas webs, que es en lo que se centra. Como digo, su uso es un poco complicado y hay que experimentar un rato con los distintos botones para conseguir la interfaz típica de los programas de memorias de traducción (como pista, diré que hay que hacer clic en extract para que aparezca la columna de traducción y es entonces cuando puede procederse como con cualquier otro sistema de memorias de traducción):

Captura de pantalla de la interfaz de WebBudget XT.
Extraído de http://tinyurl.com/d5cydld [Consulta: 17/VI/2012]
Además, este programa ofrece la posibilidad de realizar un presupuesto basándose en el o en los archivos que se le indiquen.

Wordfast, por último, es muy similar a MetaTexis, dado que se integra perfectamente en Word. Sin embargo, su uso es algo complicado al principio, pero funciona como cualquier otro software de traducción y además tiene la ventaja de que no es de pago (razón por la cual su interfaz quizá no resulta tan atractiva o intuitiva como las de Déjà Vu o Trados, pero esto debe considerarse como algo secundario, pues lo importante es su funcionamiento y la calidad de los resultados que ofrece):

Captura de pantalla de Wordfast. Extraído de
http://www.translatorstraining.com/mat/cat/cat.htm
[Consulta: 17/VI/2012] 

Creo que la mejor forma de ser un traductor cada vez más competitivo (y más en los tiempos que corren) es  estar reciclándose continuamente e investigar todo lo posible sobre cualquier programa de traducción que pueda ayudarnos en el futuro, ya sea en nuestro trabajo como traductores o para engrosar nuestro currículum y dar una mejor impresión a la empresa en la que queramos trabajar.

viernes, 11 de mayo de 2012

Resumen de las funciones de una memoria de traducción

A raíz de un resumen de las funciones de una memoria de traducción que nos ha facilitado la profesora hoy en clase, he creído conveniente, aun a riesgo de repetirme, repasar dichas funciones. Y digo que a riesgo de repetirme porque soy consciente de que muchas de estas cuestiones ya las he comentado, por lo que, en muchos casos, me limitaré a dirigir a la entrada correspondiente para, así, tenerlo todo más ordenado (al menos, esa es mi intención) y, de paso, consolidar los contenidos (aunque ya los hemos consolidado mediante la práctica realizada en la clase de hoy).

Asimismo, para todas estas cuestiones en general, también pueden consultarse las entradas Términos claves de Informática Aplicada a la Traducción (I) y Términos claves de Informática Aplicada a la Traducción (II).

Aquí presento el esquema; intentaré completarlo de la forma más conveniente.

Prestaciones básicas de las memorias de traducción

Definición de los conceptos de MT y de herramientas de las MT
à Requisitos para el uso de una MT. Para este aspecto, recomiendo las entadas Pasos previos a la creación de una memoria de traducción (I) y Pasos previos a la creación de una memoria de traducción (II).

à Ventajas y desventajas en el uso de MT. A esto también le dediqué una entrada, Memorias de traducción: ¿amigo o enemigo?

à Formatos de archivo. Además de las entradas dedicadas a los términos claves de la asignatura, puede consultarse la entrada El formato .tmx y el lenguaje html.

Componentes
Como ya he dicho en varias ocasiones, los componentes básicos de cualquier memoria de traducción son tres: un proyecto, una memoria de traducción y una base de datos terminológica. Estos son contenedores diferentes, por lo que son independientes.

Ahora bien, también puede decirse que los componentes básicos de una memoria de traducción son los siguientes:

à Editor: podríamos decir que se trata de la parte en la que se traducen los distintos segmentos del texto original. Creo que no es necesario explicar el proceso de traducción mediante los sistemas de traducción asistida, puesto que lo he mencionado en varias ocasiones a lo largo de muchas de las entradas del blog.

à Base de datos terminológica. Además de las entradas ya citadas, pueden consultarse La extracción de términos y La importancia de la terminología en los programas de memorias de traducción.

à Memoria de traducción (propiamente dicha). Ya lo he explicado en varias ocasiones: la memoria de traducción contiene una serie de documentos alineados (los segmentos de un número indefinido de textos origen junto con sus correspondientes segmentos de los textos meta) y es muy útil para el trabajo del traductor, que puede aprovecharla mediante los programas de memorias de traducción como Déjà Vu, que es con el que más nos hemos familiarizado a lo largo de este cuatrimestre.

Creación de una MT
Para la creación de cualquier memoria de traducción, hay que seguir una serie de pasos básicos, que ya expliqué en Pasos para la creación de una memoria de traducción y en la segunda parte de la misma entrada.

De todas formas, a modo de recordatorio, algunos de los pasos básicos para la creación de una memoria de traducción son los siguientes:

à Selección de idiomas tanto del texto origen como del texto meta, pues es información que necesita el programa de traducción asistida para poder gestionar los archivos y para poder recuperarlos de forma correcta.

à Gestión de archivos. La memoria de traducción se compone de una serie de archivos, cuyas ubicación y extensiones conviene conocer (dichas extensiones pueden consultarse en Términos claves de Informática Aplicada a la Traducción).

à Configuración del usuario. Resulta muy útil la opción de poder etiquetar las memorias de traducción (por idioma, cliente o ámbito de especialización, por ejemplo) para que el programa de traducción asistida pueda recuperar la información que desee el traductor (también por idioma, por cliente o por ámbito de especialización) y que pueda sacarle provecho en cuanto a la eficiencia y a la calidad de su trabajo.

à Opciones para coincidencias parciales. De las coincidencias parciales o fuzzy matching y de sus ventajas e inconvenientes he hablado, por ejemplo, en ¿Son las fuzzy matches útiles para el traductor?

Flujo de trabajo durante la traducción con MTs: pasos y procesos
¿Qué pasos hay que seguir cuando se trabaja con un programa de memoria de traducción? ¿Qué opciones  y funciones ofrecen dichos programas?

à Pseudotraducción. Esta función es la que también se denomina deep mining: el programa de traducción asistida aprovecha de forma inteligente segmentos que tienen unas coincidencias altas y sustituye los términos distintos mediante la memoria de traducción y el lexicón almacenados (es decir, deduce la traducción de un determinado segmento a partir de la traducción de varios segmentos, que utiliza de forma inteligente).
     Además de las entradas sobre términos de la asignatura, ya citadas, puede consultarse la entrada Un vistazo a Déjà Vu X2, que también puede aprovecharse para realizar un breve repaso del programa de traducción asistida.

à Pretraducción. De esta y de otras funciones he hablado en Análisis en profundidad del programa de traducción asistida Déjà Vu. Sin embargo, a modo de recordatorio, la pretraducción es una traducción automática que realiza el programa; es especialmente útil para textos repetitivos y le ahorra mucho tiempo al traductor, que solo tendrá que revisar la traducción automática que resulte de este proceso.

à Trabajar con segmentos. Como ya he explicado en varias ocasiones, la memoria de traducción se alimenta de una serie de segmentos alineados (texto origen junto con su correspondiente texto meta), por lo que resulta muy útil aprovechar dicha memoria para agilizar el proceso de traducción y también para conseguir que las traducciones sean más coherentes.

à Función de propagación. También he hablado de esta función en varias ocasiones: mediante la función de propagación, el programa de traducción asistida busca segmentos iguales o similares a los ya traducidos y, tras solicitar la confirmación del usuario, los inserta en aquellos segmentos que todavía no se han traducido y que son iguales o muy similares. En pocas palabras, rellena de forma automática aquellos segmentos cuya traducción todavía no se ha escrito pero que ya se ha realizado con anterioridad, por lo que le ahorra mucho trabajo al traductor y, una vez más, le asegura la coherencia en su trabajo.

à Concordancia: como explica Cristina Márquez Arroyo, la concordancia «permite encontrar todas las unidades que incluyen una palabra o frase determinada, con solo pulsar un botón. El resultado aparece en una ventana adicional que muestra todas las traducciones existentes, con la indicación de la fecha en que fueron realizadas y el nombre del usuario que las introdujo»(1). 

Integrar Bases de datos
Aun siendo consciente de que me repito, creo que es necesario volver a decir que cualquier memoria de traducción se compone de tres elementos básicos: el lexicón (o lexicon), la base de datos terminológica y la memoria de traducción propiamente dicha:

à Lexicon (o lexicón): base de datos terminológica creada ad hoc, es decir, para un proyecto determinado. Cuando finaliza dicho proyecto, el lexicón se integra en la base de datos terminológica.

à Base terminológica: base de datos que incluye una serie de términos, que están emparejados (término origen junto a su correspondiente traducción) y que también incluye, lo que es muy importante, el contexto de uso de dichos términos. Estas bases de datos pueden ser multilingües y multiámbitos, por lo que pueden ser muy beneficiosas para el trabajo del traductor.

à Memoria de traducción: como ya lo he explicado varias veces, solo diré que se compone de una serie de segmentos alineados y que puede ser de gran ayuda para el traductor.

Una vez más, recomiendo, para más información sobre estos términos, la lectura de Términos claves de Informática Aplicada a la Traducción.

Crear una memoria de traducción
Como este procedimiento es básico y ya lo he explicado en varias entradas (por ejemplo, en Pasos previos para la creación de una memoria de traducción, tanto en la primera parte como en la segunda), y como los siguientes epígrafes resumen perfectamente el proceso de creación de una memoria de traducción, no lo explicaré en profundidad:

à Durante la traducción (conforme se traduce, puede ir creándose una memoria de traducción, independientemente de si ya se dispone de alguna otra memoria de traducción o no).

à Importar una memoria externa (es muy útil la posibilidad de poder importar memorias de traducción externas al propio proyecto de traducción, puesto que el traductor va a disponer de más recursos para traducir dicho proyecto).

à Crear una alineación

Actualizar la memoria de traducción
La memoria de traducción hay que actualizarla continuamente y corregirla si es necesario, pues puede haber errores que, si no se corrigen, podrían perjudicar al traductor en su trabajo. Así, a medida que se vayan recibiendo correcciones, el traductor debe actualizar la memoria de traducción:

à        Durante la traducción
à        Después de traducir
à        Con una MT externa

Tanto durante la traducción, como una vez finalizado el proyecto; también es muy útil utilizar para esta actualización memorias de traducción externas.

Trabajar con archivos con etiquetas
Déjà Vu, como muchos otros programas de traducción asistida, tiene la ventaja de que se pueden traducir textos de una gran diversidad de formatos, dado que el programa utiliza una serie de filtros que conservan el formato del texto original y que el traductor no ve (por lo que no le dan problemas). Una vez que haya terminado el proyecto, el programa volverá a recuperar dichos filtros, obteniéndose así un texto meta  exactamente igual al texto origen en cuanto al formato.

Así, existen dos tipos de etiquetas:

à  Etiquetas estructurales: se refieren a todo lo que afecta al formato externo del archivo; en Déjà Vu, por ejemplo, desaparecen, por lo que no pueden dar ningún tipo de problemas.

à Códigos incrustados: son los números que en Déjà Vu aparecen entre llaves y que hacen referencia a formatos como la negrita, la cursiva o el subrayado, como ya expliqué en su momento (en esta entrada, por ejemplo). La mayoría de los problemas que surgen al exportar el proyecto se deben a problemas con dichos códigos, por lo que el traductor debe tener cuidado con dichos códigos y no modificarlos, pues podría alterar el formato del proyecto en su conjunto.

Control de calidad
à Corrección ortográfica
à Verificación etiquetas
      à Comprobación terminológica

También de este aspecto he hablado a lo largo de las entradas de este blog. El control de calidad consiste, a grandes rasgos, en comprobar el proyecto ya traducido, que debe incluir una corrección ortográfica, una corrección de estilo, una comprobación terminológica (es decir, si los términos se han traducido correctamente desde el punto de vista de la propia traducción y también desde el punto de vista del ámbito del texto o del cliente que lo ha encargado, por ejemplo) e, incluso, una comprobación del formato del texto o proyecto final, en la que debe realizarse, obligatoriamente, una verificación de las etiquetas para que no haya problemas de formato, como acabo de mencionar en el apartado anterior.

Análisis y estadística
à Objetivos de las funciones de análisis y estadística: el programa de traducción asistida Déjà Vu ofrece la posibilidad de realizar un análisis exhaustivo en cuanto a las estadísticas del proyecto. Dicho análisis ofrece datos como el trabajo que está realizando el traductor en ese proyecto, dónde se encuentra la memoria, cuántos proyectos contiene y distintos porcentajes, como de similitud con la memoria o de repeticiones internas. Asimismo, esta información puede guardarse y enviarse al cliente, si es necesario.

à Tipos de repetición (interna o externa): las repeticiones internas también se conocen como duplicados y son segmentos que aparecen más de una vez en el mismo documento; una vez que se hayan traducido por primera vez, el programa de traducción asistida, mediante la función de propagación, insertará dicha traducción en los segmentos que sean iguales. En cuanto a las repeticiones externas,  estas son las coincidencias exactas que se dan entre el texto que se está traduciendo y la memoria de traducción, y se llaman repeticiones externas porque ya provienen de proyectos anteriores de traducción y, por lo tanto, están disponibles antes de comenzar a traducir.(2)

à Tipos de coincidencia (difusa o 100%): ya he hablado en muchas ocasiones sobre las coincidencias totales y las coincidencias parciales o fuzzy matches, por ejemplo, en la entrada  ¿Son las fuzzy matches útiles para el traductor?

à Reglas de segmentación: las reglas de segmentación son los parámetros de los que dispone el programa de memoria de traducción (o de segmentación) para realizar la segmentación del texto. Dicha segmentación se realiza por defecto a partir del punto (es decir, un segmento finaliza en un punto y da comienzo al siguiente segmento que, a su vez, termina en el siguiente punto), aunque el usuario puede cambiarlo si lo considera necesario.
      Una vez que el texto esté segmentado, se procederá a la alineación (sobre la que puede verse más información en esta entrada) y a continuación.

Alineación
à        Reciclar traducciones anteriores
à        Automática y manual
à        Cómo unir/dividir/eliminar segmentos
      à        Guardar proyectos de alineación e importarlos a la memoria

Como acabo de decir, la segmentación da paso a la alineación, que se realiza a partir de traducciones ya finalizadas, puesto que consiste en alinear los segmentos del texto original junto con sus correspondientes traducciones. Esta alineación puede hacerse de forma automática (el programa, mediante las reglas de segmentación, divide de forma automática el texto origen y el meta en una serie de segmentos y los une automáticamente) o de forma manual (el traductor une cada segmento con su correspondiente traducción, partiendo desde cero o corrigiendo lo que haya hecho de forma automática el programa de alineación).

De hecho, en la alineación manual, en algunas ocasiones el traductor tendrá que modificar los segmentos, uniéndolos, dividiéndolos o incluso eliminándolos para que los segmentos origen se correspondan con los meta y para que, una vez guardados e importados a la memoria, puedan aprovecharse y supongan una ventaja para su trabajo.

Gestión de la memoria de traducción
à        Compactar
à        Eliminar duplicados

Finalmente, la memoria de traducción puede compactarse, es decir, pueden agruparse los datos de la memoria para que esta ocupe menos espacio (solo hay que ir a herramientas>compactar); de hecho, también pueden compactarse un proyecto o la base de datos terminológica. Asimismo, el programa ofrece la posibilidad de buscar aquellos segmentos o términos duplicados (es decir, que cuenten con traducciones distintas) y visualizarlos por separado para decidir cuál su la traducción más adecuada y para eliminar aquella que no lo sea.

Espero que, tras este resumen (que ha sido más extenso de lo que había previsto), se hayan consolidado los conceptos más importantes sobre las memorias de traducción.

______________________
(1) Márquez Arroyo, Cristina: «Herramientas de traducción automática... mito y realidad», accesible en: http://bscw.rediris.es/pub/bscw.cgi/d469719/Herramientas%20de%20traducci%C3%B3n%20autom%C3%A1tica...%20mito%20y%20realidad%20(Cristina%20M%C3%A1rquez).pdf [Consulta: 8/V/2012]
(2) Heinz Freignang, Karl: «Tipos de repetición (interna o externa) (2/8)» en eCoLoTrain, accesible en: http://ecolotrain.uni-saarland.de/index.php?id=1529&L=3 [Consulta: 8/V/2012]

jueves, 3 de mayo de 2012

Análisis en profundidad del programa de traducción asistida Déjà Vu

A raíz de otro artículo muy interesante de la revista Panace@(1), me gustaría hablar más en profundidad del programa de traducción asistida (al que también me he referido en varias ocasiones como programa de memoria de traducción) Déjà Vu. Aunque lo he mencionado con mucha frecuencia a lo largo de las entradas del blog y aunque ya hablé de las funciones básicas de un programa de memoria de traducción (Traducir mediante una memoria de traducción: funciones y herramientas básicas), este artículo me ha servido para tener una visión más amplia de este programa y, por ello, me gustaría compartir en este blog todo lo que he aprendido en dicho artículo.

En qué consiste Déjà Vu

El autor del artículo comienza en su introducción definiendo las características de Déjà Vu: debido a que combina la tecnología de las memorias de traducción con las técnicas de traducción automática, permite mejorar tanto la productividad del traductor como la coherencia en su trabajo. Asimismo, con este programa puede realizarse una gestión de proyectos de forma eficiente.

La novedad con respecto a otros sistemas de traducción asistida radica en que utiliza de forma inteligente la memoria de traducción, la base de datos terminológica y el lexicón para ensamblar las traducciones de varios segmentos más pequeños en uno solo más grande: el programa intuye como si fuera un traductor humano y realiza lo que se denomina deep mining (ver término 19 de Términos claves de Informática Aplicada a la traducción). Además, como también he mencionado en varias ocasiones, el programa puede trabajar con la mayoría de formatos de archivo, dado que, en su interfaz, solo presenta el texto que va a traducirse y cualquier información codificada del texto origen la protege para que no pueda alterarse (de esto también hablo en la entrada dedicada a las funciones de los programas de memorias de traducción).

Qué tiene Déjà Vu que no tengan otros programas de traducción asistida

Tras un análisis de las funciones básicas de Déjà Vu, el autor pasa a lo que nos interesa: las funciones específicas de Déjà Vu.

1. Escaneado (scan)

En primer lugar, habla de la función de escaneado, esto es, el programa busca si existen correspondencias exactas o aproximadas de los segmentos que se está traduciendo y, en el caso de que sí las haya, incluirá dichas traducciones (para más información, pueden verse las coincidencias totales y parciales o fuzzy matching, 12, y la autopropagación, 13, en esta entrada). Asimismo, puede reparar de forma automática las coincidencias aproximadas o la traducción automática basada en ejemplos. Después de todo este proceso, el programa puede realizar su propia traducción basándose en distintos segmentos, convirtiendo el segmento origen y el segmento meta en una coincidencia exacta, exact match (realizando el ya mencionado deep mining).

2. Ensamblado (assemble)

Esta función (exclusiva de Déjà Vu) consiste, como acabo de explicar, en combinar fragmentos menores para conseguir traducir segmentos que solo tienen una coincidencia parcial, también partiendo de toda la información contenida en sus bases de datos. 

3. Pretraducción (pretranslate)

La función de pretraducción es especialmente útil en el caso de textos muy repetitivos, en los que lo más recomendable es traducir el proyecto de forma automática y, después, revisarlo. Si a esto le añadimos que Déjà Vu busca las coincidencias (totales y parciales) para cada oración, el resultado será de mejor calidad, ya que, para ello, selecciona la mejor traducción (una coincidencia exacta garantizada, guaranteed exact match, una exacta, exact match, o una aproximada, fuzzy match).

4. Propagación (propagate)

Una vez más, esta función es adecuada para proyectos extensos y repetitivos. Como he explicado a propósito de la autopropagación, el programa buscará segmentos similares o iguales a los ya traducidos y solicitará una confirmación para insertar una coincidencia aproximada autorreparada (self-repaired self-match).

5. Autobúsqueda (autosearch)

También he hablado de esta función en una de las entradas dedicadas a los términos claves de la asignatura. En resumen, el programa realiza una búsqueda automática de términos, segmentos y términos almacenados para poder aplicar su correspondiente traducción al texto que se está traduciendo. Asimismo, muestra su correspondiente información contextual, lo que es de gran ayuda.

6. Gestión de proyectos

Un aspecto muy interesante es el hecho de que Déjà Vu permite realizar gestiones de proyectos (sobre los que hablé aquí y aquí). De esta forma, pueden crearse proyectos satélites, también conocidos como Pack&Go: se trata de pequeños archivos monolingües que pueden reimportarse al proyecto plurilingüe principal y que pueden transportarse con facilidad debido a que no contienen información sobre formato o imágenes. También pueden distribuirse pequeñas bases de datos (cuyo contenido haya seleccionado previamente el gestor) para facilitar el trabajo del traductor y asegurarle coherencia, además de que el gestor también se asegurará de que las memorias de traducción y las bases de datos terminológicas no se dispersarán entre los distintos traductores.

Asimismo, el gestor de proyectos puede asignar derechos de acceso individual a cada miembro de un grupo de traductores, para que cada uno trabaje solo en lo que se le ha asignado y no modifique el trabajo de los demás, sin por ello dejar de ofrecerles el texto en su conjunto. Incluso puede agregar información a los segmentos o responder a las dudas que puedan tener los traductores mediante la función de comentario (comment).

7. Control de calidad

Esta función, como su nombre indica, permite verificar que la terminología o los códigos, por ejemplo, se han utilizado de forma adecuada e, incluso, puede mostrar, si las hay, otras opciones de traducción de determinados segmentos o términos. Esto beneficia tanto a los traductores (cuyas traducciones serán de mejor calidad) como a los gestores (que podrán asegurarse de que los traductores han seguido sus instrucciones y que también podrán corregir cualquier fallo u omisión).

8. Entorno integrado

Con esto, el autor del artículo que estoy comentando se refiere a que todas las tareas pueden realizarse en la misma interfaz de usuario del programa, dado que esta se adapta a cualquier necesidad. De hecho, el usuario puede incluso definir y personalizar sus propias barras de menú, atajos del teclado, esquemas de color, ventanas de herramientas...

Así, algunas de estas funciones son la ya mencionada autobúsqueda (recordemos que basta con pulsar la combinación de teclas Ctrl. + el número del término para incluirlo de forma automática en el segmento) y características propias de cualquier procesador de textos, como autocorrección y autotexto (similares a las de Microsoft Word), y corrección de ortografía de hasta 14 idiomas (si se trabaja con otro idioma, basta con utilizar el corrector de Word de ese idioma que, por supuesto, tiene que estar instalado). Incluso es posible utilizar los atajos comunes de Windows (copiar, cortar, pegar, buscar, reemplazar, seleccionar texto y las muy útiles y necesarias deshacer y rehacer).

 9. Formatos de archivo admitidos

Déjà Vu admite prácticamente todos los formatos de archivos a excepción de algunos como el .pdf (que es cierto que da problemas de compatibilidad a la mayoría de los programas, sean de lo que sean). Recordemos, asimismo, que el programa utiliza una especie de filtro, de forma que, mientras se está traduciendo, solo muestra la parte escrita del texto (o proyecto) origen y, una vez que se ha traducido, exporta el texto meta con el mismo formato del texto (o proyecto) original. También hay que añadir que permite que el intercambio de las bases de datos terminológicas y de las memorias de traducción se haga fácilmente (además de que siempre puede recurrirse al formato .tmx para exportar las memorias de traducción).

10. Administración de las terminologías

Sobre este aspecto no tengo nada más que añadir, dado que ya lo he dicho todo en entradas como esta. Sin embargo, sí debo decir que Déjà Vu puede personalizar los términos almacenados por categorías y atributos e incluso por clientes, algo que es muy útil. Incluso ofrece la posibilidad de incluir relaciones de sinonimia y antonimia entre términos de un mismo idioma.

11. Mantenimiento de las bases de datos

A pesar de que sobre este aspecto tampoco tengo mucho que añadir, solo mencionaré que los glosarios son multilingües y multiámbitos y que, además, el idioma de origen de una base de datos puede convertirse en el idioma meta de otras, lo que resulta de gran utilidad. Asimismo, también pueden importarse y exportarse glosarios y memorias de traducción para intercambiarlos con otros traductores o enviárselos al cliente.

12. Alineación

Déjà Vu también cuenta con una herramienta para realizar alineaciones de segmentos que, a continuación, podrán agregarse a la memoria de traducción (para más información sobre la alineación, ver esta entrada).

13. Lexicón del proyecto

También he comentado esta función en varias ocasiones (por ejemplo, en esta entrada, además de en otras ya citadas) a propósito de que supone una herramienta muy útil para garantizar la coherencia en el uso de la terminología. Déjà Vu es capaz de realizar una extracción terminológica de forma automática, a partir de la que puede crearse un lexicón.

Además de esto, Déjà Vu puede traducir los lexicones de forma automática para así crear bases de datos a partir de proyectos ya existentes. Esto, como es lógico, también afecta a la calidad de la gestión del proyecto de traducción, puesto que el gestor puede distribuir un glosario unificado a todos los miembros de un equipo de traducción y la calidad de la traducción final y el trabajo del traductor serán mucho mejores.

¿Y las desventajas?...

La única desventaja de Déjà Vu parece ser, por lo tanto, que hay que acostumbrarse a todas estas funciones, pero yo no considero esto un obstáculo, dado que, como con cualquier programa que tenga una interfaz mínimamente intuitiva (como es el caso), cualquier usuario puede acostumbrarse rápidamente a su uso. Además, como cualquier programa de cierta calidad, ocupa mucho espacio en el disco duro del ordenador, pero creo que estos son problemas menores y más si tenemos en cuenta todas las ventajas que ofrece.

Podría concluir que este artículo dedicado a las distintas funciones específicas de Déjà Vu me ha sido de gran utilidad para ampliar mis conocimientos sobre dicho programa; de hecho, había funciones que no conocía, pero incluso sobre las que ya conocía he descubierto nuevos aspectos. Por último, también había términos que desconocía (coincidencia exacta, coincidencia exacta garantizada, coincidencia aproximada autorreparada...) y que ahora he incorporado a mi glosario personal, es decir, a mis conocimientos sobre esta asignatura (sobre la que, me estoy dando cuenta, nunca se deja de aprender).

Recomiendo encarecidamente visitar la página web de ATRIL, donde pueden verse vídeos explicativos sobre el uso de Déjà Vu.


__________________________
(1) H. Gauna, Daniel: «Nuevas vistas a la traducción con Déjà Vu» en Panace@, vol. 10, n.º 29, junio de 2009, accesible en: http://www.medtrad.org/panacea/IndiceGeneral/n29_tribuna-Gauna.pdf [Consulta: 3/V/2012]

sábado, 28 de abril de 2012

Términos claves de Informática Aplicada a la Traducción (II)

Términos más específicos relacionados con las memorias de traducción

Tras una primera entrada de conceptos más generales de Informática aplicada a la traducción, voy a proseguir con términos más específicos que tienen que ver con las memorias de traducción. Como ya expliqué en qué consiste una memoria de traducción (ver término 9 de dicha entrada), voy a pasar a definir los siguientes términos:


12. Coincidencias totales y coincidencias parciales o fuzzy matching

El programa de memorias de traducción contiene una memoria de traducción dividida en una serie de segmentos en lengua origen, que están almacenados junto a su correspondiente equivalente en lengua meta (ver términos 10 y 11). Así, cuando se está traduciendo un texto nuevo, dicho programa realiza una búsqueda para localizar aquellos segmentos del texto nuevo que ya se hayan traducido previamente y que, por lo tanto, se encuentren almacenados en la memoria.

Si ya hay un segmento almacenado en la memoria que es prácticamente (o exactamente) igual al segmento nuevo, se habla de coincidencias totales. Si la coincidencia es solo parcial, se habla de fuzzy matching. 

12. 1. Umbral de sensibilidad

Además, puede indicársele al programa que aplique un determinado umbral de sensibilidad en la búsqueda de coincidencias; se aplica un grado que puede ir de 0 a 100 y que, por defecto, suele ser de un 75% dado que, si se es demasiado exigente con el programa y se le pide que encuentre coincidencias exactas, será muy poco probable que las encuentre (y habrá demasiado silencio, en contraposición al ruido, que se dará cuando el umbral sea demasiado bajo y, por lo tanto, aparezcan demasiados resultados; es lo mismo que ocurre cuando se realiza una búsqueda en un motor de búsqueda).

13. Autopropagación

De esta forma, en el programa de memorias de traducción puede activarse la opción de autopropagación (esto puede hacerse, por ejemplo, en Déjà Vu), de forma que, si un determinado segmento ya se ha traducido y vuelve a aparecer en el texto que se está traduciendo, el programa introducirá la traducción que ya se haya realizado (esto es especialmente útil en el caso de textos muy repetitivos, puesto que le ahorra mucho tiempo al traductor y le asegura que será coherente en su traducción).

De esta y de otras funciones básicas de cualquier sistema de memoria de traducción hablo en Traducir mediante una memoria de traducción: funciones y herramientas básicas.

13.1. Autocomprobación 

Además, el programa de memoria de traducción va comprobando que la traducción de los segmentos que realiza el traductor se corresponde con la que tiene almacenada (si no, como en el caso de Déjà Vu, el programa avisa al traductor mediante un signo de exclamación en rojo).

14. Unidad de traducción

Este concepto es bastante abstracto, puesto que la unidad de traducción se corresponde con el segmento que se traduce. En otras palabras, la unidad de traducción puede abarcar desde una palabra hasta una oración entera (e incluso los hay que afirman que traducimos textos y no palabras ni oraciones). En cualquier caso, para los sistemas de memorias de traducción, la unidad de traducción es el segmento, como ya expliqué (ver 11).

Hablar de «unidad de traducción» nos lleva a «afinar» un poco más en cuanto a los términos que van a definirse, es decir, a ser más específicos y a centrarnos en unidades de traducción más pequeñas, como pueden ser las palabras, cuya traducción correcta (teniendo en cuenta el contexto en cada caso) hay que conocer e indicar al programa:

15. Término

Como ya he dicho en varias ocasiones, tras dos asignaturas de Terminología, la definición de término no supone ninguna dificultad. Como ya definí en la entrada La importancia de la terminología en los programas de memoria de traducción, un término es una unidad léxica compuesta por una o más palabras que adquiere su significación en función de un ámbito determinado; en muchas ocasiones, de hecho, solo en función del contexto sabremos el significado y la acepción de un término dado.

Para ello es fundamental realizar una extracción terminológica, en la que conviene indicar las distintas traducciones de los términos en función de su contexto de uso.

15.1. Extracción terminológica

También a la extracción terminológica le dediqué una entrada, por lo que solo diré que consiste en recopilar de una serie de textos especializados aquellas palabras que puedan considerarse términos. Esto se puede hacer de forma automática mediante programas como Lexterm o mediante el que incluye Déjà Vu y, aunque no lo parezca, ahorrará mucho tiempo al traductor cuando esté realizando la traducción, además de que le asegurará una coherencia interna en su trabajo, como no me he cansado de repetir.

Para un análisis más detallado de la extracción terminológica, así como de sus ventajas, ver La importancia de la terminología en los programas de memoria de traducción y La extracción de términos.

15.1.1. Las stopwords


A propósito de la extracción terminológica, conviene recordar un término muy relacionado, el de stopword, aquellas palabras que están vacías de contenido. Cuando el programa realiza una extracción terminológica automática, puede marcarse como preferencia que no incluya dichas palabras en su extracción (en internet hay muchos listados de estas palabras, además de que muchos programas de extracción terminológica las incluyen; es el caso de Lexterm).

Aun a riesgo de repetirme, para más información sobre las stopwords, puede consultarse la entrada anteriormente citada La extracción de términos.
Volvamos ahora a ampliar un poco la cuestión de las palabras y de los términos. ¿En qué tipo de listas se incluyen?

16. Base de datos terminológica

Una base de datos terminológica es, simplemente, una base de datos (esto es, un contenedor de datos) que incluye una serie de términos recopilados por pares, es decir, incluye el término original junto a su traducción y, lo que es más importante, también incluye su contexto, el ámbito en el que se utiliza (ya he insistido en varias ocasiones en la importancia del contexto en la traducción de términos).

Asimismo, la base de datos terminológica puede ser multilingüe (es decir, incluir la traducción correspondiente del término en más de un idioma) y multiámbito (dado que un mismo término puede tener distintas acepciones según el contexto del uso, por lo que es de gran importancia que esto esté bien indicado en la base de datos terminológica).

Una vez más, de estos temas hablo en La importancia de la terminología en los programas de memoria de traducción.

17. Léxico, lexicón

Un léxico, por lo tanto, sería una base de datos terminológica ad hoc, esto es, creada para un proyecto de traducción determinado. Así, una vez que se finalice el proyecto, dicho léxico pasaría a formar parte de la base de datos terminológica. Dado que es un glosario ad hoc, no hace falta incluir el ámbito de uso, puesto que en un proyecto de traducción determinado solo habrá un contexto.

Un lexicón es lo mismo que el léxico, aunque el término lexicón se utiliza con más frecuencia, a mi juicio, en lo relativo a la traducción automática y asistida.

También al léxico y al lexicón les dedico la entrada La importancia de la terminología en los programas de memoria de traducción y La extracción de términos.

18. Autobúsqueda

Muy relacionada con los términos anteriores está la función de autobúsqueda que ofrecen los sistemas de memorias de traducción (como Déjà Vu, sin ir más lejos). Si esta opción está activada, el sistema buscará de forma automática si existe algo aprovechable en las distintas bases de datos (memorias de traducción, bases de datos terminológicas, lexicones...), esto es, si puede utilizar traducciones de segmentos o de términos ya realizadas en el texto que se está traduciendo (una vez más, esto asegura la coherencia del trabajo del traductor).

Para una explicación de la autobúsqueda más «en contexto», ver, una vez más, La importancia de la terminología en los programas de memoria de traducción.

19. Deep mining

Retomo los conceptos de autopropagación (13) y autobúsqueda (18) para explicar brevemente en qué consiste el deep mining. Se trata, simplemente, de una búsqueda inteligente: a partir de las distintas fuentes de las que dispone (memorias de traducción, bases de datos terminológicas, lexicones..), el programa realiza una autobúsqueda y, empleando distintos segmentos, el propio programa es el que propone una traducción, es decir, que es el propio programa el que deduce la traducción del segmento nuevo.

A propósito del deep mining, puede leerse la entrada Deep mining with Déjà Vu X2.

20. Autoensamblaje

Lo contrario al deep mining sería el autoensamblaje: el programa solo introduce los resultados de distintos segmentos, sin deducir ni intuir cuál podría ser la traducción del segmento nuevo (que se diferencia de la autopropagación, ver 13, dado que esta se aplica en el caso de coincidencias totales de segmentos).

21. Principales formatos o extensiones que un traductor debe conocer

Para terminar con esta entrada, me gustaría indicar brevemente las principales extensiones que un traductor que esté trabajando con sistemas de memorias de traducción debe conocer (por ejemplo, a la hora de importar un determinado archivo al proyecto de traducción o al buscar un determinado archivo exportado del proyecto de traducción). No hablo ya del .doc(x) o del .jpg, puesto que doy por hecho que eso ya es de sobra conocido, por lo que pasaré a explicar otros más específicos con los que me he encontrado durante el desarrollo de la asignatura y, especialmente, al utilizar el programa Déjà Vu.

21.1. tmx

Formato estándar para las memorias de traducción que permite que dichas memorias puedan intercambiarse entre distintos programas de memorias de traducción sin que haya problemas de compatibilidad. Es el acrónimo de Translation Memory eXchange.

En el .tmx pueden encontrarse dos tipos de informaciones, etiquetas y contenidos. Las etiquetas dan información y van asociadas a una serie de parámetros y variables, suelen ser dobles (es decir, hay una de apertura, < >, y otra de cierre, </ >) y están escritas en lenguaje html. Los contenidos son toda la información que se encuentra incluida en dichas etiquetas.

Para más información, ver El formato .tmx y el lenguaje html.

Las siguientes extensiones son propias del programa Déjà Vu. Aunque a simple vista parezcan complicadas de reconocer, son muy fáciles de deducir. Como es lógico, solo se pueden abrir con dicho programa.

21.2. dvprj

Esta extensión corresponde al proyecto de traducción de Déjà Vu (dv es Déjà Vu y prj, project). 

21.3. dvmdb

Esta extensión corresponde a la memoria de traducción de Déjà Vu (Déjà Vu Memory DataBase).

21.4. dvmdx

El archivo que tiene esta extensión contiene otro tipo de información, tales como el nombre del proyecto y de los archivos.

21.5. dvmdi

Los archivos que están guardados con esta extensión corresponden a cada una de las lenguas con las que se está trabajando en el proyecto. Así, si se está trabajando con el inglés (como lengua origen, por ejemplo) y con el español (como lengua meta, por ejemplo), habrá dos archivos distintos con dos extensiones distintas, .en.dvmdi (inglés) y .es.dvmdi (español).

21.6. dvtdb

Este formato indica que se trata de una base de datos de terminología de Déjà Vu (Déjà Vu Terminology DataBase). 

Para más información sobre las extensiones mencionadas arriba, ver Déjà Vu X Professional. Guía de introducción al uso y 12 facts, hints and ideas on databases in DVX2.

martes, 24 de abril de 2012

Términos claves de Informática Aplicada a la Traducción (I)


Términos generales e introductorios a la asignatura

sábado, 21 de abril de 2012

La importancia de la terminología en los programas de memorias de traducción

En una entrada anterior hablé sobre la extracción de términos mediante el programa de código abierto Lexterm; sin embargo, no incidí demasiado en la importancia de la terminología en los programas de memorias de traducción, puesto que me centré exclusivamente en el proceso de extracción terminológica, que también es de gran importancia para los programas de memorias de traducción. Este es el motivo de la presente entrada.

Como dije en la entrada anterior (Traducir mediante una memoria de traducción: funciones y herramientas básicas), en cualquier proyecto de traducción son necesarios tres componentes: un proyecto, una memoria de traducción y una base de datos terminológica; estos tres elementos, como ya dije, están relacionados. La terminología (que es el tema que nos ocupa ahora) depende de la situación concreta del proyecto de traducción, así como del tipo (es decir, el tema o el ámbito al que pertenece, el cliente que lo ha encargado...).

¿Qué es un término?

A modo de introducción, me gustaría responder a la pregunta que encabeza este apartado: ¿qué es un término? A estas alturas de la carrera y después de dos asignaturas de Terminología, esto ya no nos parece algo nuevo. Sin embargo, creo que conviene recordarlo: un término, tal y como vimos en clase, es una unidad léxica compuesta por una o más palabras que adquiere su significación en función de un ámbito determinado. Es fundamental tener en cuenta el ámbito al que pertenecen dichos términos, pues es ahí donde se especializan y donde adquieren su significado; además, este significado (y, por lo tanto, la traducción) de un término puede variar en función de su contexto de uso, por lo que es necesario que el ámbito al que pertenecen los términos esté perfectamente delimitado.

De hecho, he de decir que los sistemas de memorias de traducción son mucho más productivos cuando se utilizan lenguajes especializados, pues es ahí donde entra en juego la terminología y es ahí donde los resultados del programa de memorias de traducción pueden mejorar.

¿Cuál es la utilidad de la terminología en las memorias de traducción? 

Sin embargo, los sistemas de memorias de traducción no son automáticos (a pesar de que sean capaces de realizar una traducción que podríamos considerar semiautomática), por lo que el usuario es clave para cerciorarse de la calidad de la lista de términos que hayan propuesto estos sistemas (insisto en que de la extracción terminológica ya hablé de forma, creo, exhaustiva). 

Una vez que se haya insertado la lista de términos en el sistema, este puede utilizarla de tres formas: en primer lugar, para que el traductor vaya realizando su propia traducción (una traducción humana/automática, donde el sistema se encarga de comparar la traducción automática de determinados términos con la que contiene en su propia base de datos, descartando aquellas traducciones que no tenga almacenadas); en segundo lugar, para que el traductor automático utilice estos términos para hacer su propia traducción (traducción conocida como semiautomática o como autoensamblaje, en la que el sistema propone la traducción solo de determinados fragmentos, pues traduce lo que tiene almacenado y lo que no traduce lo deja en inglés, y es esto lo que tiene que completar el traductor) y, en tercer lugar, para que el sistema las utilice para proponer candidatos de traducción.

La terminología resulta fundamental para el traductor, puesto que le garantiza una coherencia interna (evitándole así al lector una confusión debida a una incoherencia en la traducción de un determinado término). Además, si el sistema contiene una buena terminología, le avisará al traductor cuando este no traduzca como se ha establecido en dicha base de datos (lo cual redunda en lo primero, es decir, le garantiza una coherencia interna). De hecho, Déjà Vu cuenta con una opción, Check terminology, que comprueba todos los términos de su propia base de datos y marca los segmentos en los que no se ha traducido un término como debería haberse traducido.

¿Bases de datos terminológicas, léxicos, lexicones...?

Ahora bien, los programas de este tipo tienen tres bases de datos distintas: una memoria de traducción, una base de datos de términos y un léxico, que ayudan al traductor a realizar su trabajo. Una base de datos terminológica sería similar a una base de datos, con la diferencia de que los términos que contienen están recopilados por pares (es decir, el original se almacena junto a su traducción) y se incluyen los campos y ámbitos en los que se utilizan(1) (la base de datos terminológica, además, puede ser multilingüe y multiámbito). Es importante que la terminología esté bien gestionada y que las traducciones propuestas, así como los ámbitos a los que pertenece cada término, sean los adecuados.

¿Y qué es, entonces, un léxico? El léxico es un glosario de trabajo para un proyecto determinado que tiene una vida determinada; recalco que es determinado porque se trata de un glosario ad hoc, es decir, para un proyecto de traducción determinado: cuando finalice dicho proyecto, ya no será necesario su correspondiente léxico, por lo que podrá importarse a la base de datos terminológica para, así, completarla. También se les conoce como lexicones, aunque este concepto lo he visto más en el ámbito de la traducción automática...; en todo caso, son sinónimos.

Es importante tener claros estos conceptos, así como la característica fundamental que los diferencia: los léxicos tienen una vida determinada, mientras que las bases de datos terminológicas, no..., pues se están alimentando constantemente (es similar al traductor/intérprete: nunca deja de aprender ni de adquirir nuevos conocimientos).

Captura del programa Déjà Vu en el que se muestra el
momento en el que se añade un par de términos a la base
de datos terminológica.
En esta captura de pantalla de Déjà Vu podemos ver que, además, en las bases de datos terminológicas puede añadirse más información (idiomas y variantes, área a la que pertenece el término e incluso pueden especificarse los clientes; todo esto es de gran utilidad para el traductor). Asimismo, dado que la opción de «autobúsqueda» está activada, el programa muestra, de forma automática, la traducción de determinados términos que tiene almacenados en la base de datos terminológica.

¿Herramientas de gestión terminológica? ¿Memorias de traducción?...

Aunque esto quizá resulte obvio, no es lo mismo una herramienta de gestión terminológica que una memoria de traducción: mientras que la primera, como base de datos terminológica que es, solo contiene una lista de términos, la memoria de traducción tiene almacenados segmentos de textos, esto es, unidades de traducción (de los segmentos también hablé en esta entrada, a propósito de la alineación de textos), también en pares (original y traducción).

¿Cómo es la gestión terminológica en Déjà Vu y en OmegaT?

Tras la teoría viene la práctica y por ello tuvimos que aplicarlo a un ejercicio mediante Déjà Vu, en el que había que preparar un léxico mediante la memoria de traducción. Es en la práctica donde podemos apreciar las diferencias que existen entre los distintos programas de memorias de traducción.

Como ya he dicho, los sistemas de memorias de traducción tienen sus propios gestores de terminología: por ejemplo, tenemos el ya conocido Déjà Vu y el también conocido OmegaT; como es lógico, la interfaz de Déjà Vu hace que la creación de una terminología sea algo más sencillo que en el caso de OmegaT, pero no hay existen tantas diferencias (en definitiva, se trata de las diferencias que existen entre un programa de pago y uno gratuito). Además, Déjà Vu ofrece la posibilidad de especificar el cliente o el ámbito al que pertenece dicha terminología, entre otros aspectos, para así tener la información perfectamente etiquetada, tal y como ocurre con la memoria de traducción (sobre la creación de una memoria de traducción y, en concreto, sobre este aspecto, ya hablé en esta entrada).

Veamos el caso concreto de estos dos programas. Crear un lexicón en Déjà Vu a partir de una memoria de traducción es muy similar a como se hace en Lexterm, por lo que resulta muy sencillo: solo hay que seleccionar las preferencias y aceptar, y ya estará creado el lexicón:

Captura de pantalla de Déjà Vu que muestra la ventana en la que se eligen
las preferencias a la hora de crear un lexicón.

Sin embargo, de la lista que ofrece el programa, el traductor deberá seleccionar aquellas palabras que considere términos (el programa ofrece, además, la posibilidad de ver las palabras en su contexto; esto ayuda al traductor a decidir si son términos o no) y que, como tales, deban incluirse en el lexicón:

Captura de pantalla del programa Déjà Vu. Es ahora cuando el traductor
debe seleccionar solo aquellos términos que vayan a serle útiles en la
traducción y que se incluirán en el lexicón.
Además, una vez que se tenga hecho, Déjà Vu ofrece la posibilidad de exportar el léxico a un formato externo legible (por ejemplo, para que el cliente lo vea y lo apruebe). Y si el traductor, cuando ya ha empezado a traducir, ve necesario incorporar términos nuevos, también puede hacerlo (mediante las herramientas situadas en la parte superior de la interfaz del programa o mediante combinaciones de teclas):

En Déjà Vu, añadir un par de términos a la base de datos 
terminológica o al lexicón es tan fácil como seleccionar el 
término (original y traducción) y pulsar el botón «añadir par
a lexicón» (o «añadir a terminología»). 

Sin embargo, OmegaT es algo diferente, puesto que el glosario es un documento aparte que debe crearse en un editor de textos y guardarse en la carpeta Glossary (OmegaT distribuye cada componente del proyecto en carpetas diferentes). Aun así, a grandes rasgos, la forma de proceder en ambos programas es muy similar (por lo que el dominio de las funciones básicas de todo programa de memorias de traducción permite poder utilizar sin dificultad cualquier programa de este tipo).

Entonces, ¿por qué es importante la terminología?

Ahora bien, ¿por qué es de gran importancia disponer de una buena base de datos terminológica? No es solo para que el traductor pueda traducir de forma correcta y eficaz determinados términos, sino que también es importante porque, dado que el lexicón se construye antes de empezar a traducir, el traductor puede solucionar la traducción de las palabras básicas del texto, es decir, extraer palabras clave, lo que le permite familiarizarse con el ámbito del texto que está traduciendo (muchas veces hay que traducir textos cuya área de especialización no conocemos demasiado), pues con estas palabras clave accede a los núcleos de la información del tema en cuestión.

Además, garantiza la coherencia interna de la traducción, no solo en los casos en los que se trabaje en equipo, sino también cuando el traductor esté trabajando solo. Una vez que esté traduciendo, el programa realizará autobúsquedas (en el caso de Déjà Vu, por ejemplo), es decir, buscará si hay algo aprovechable en dichas bases de datos y avisará al traductor en el caso de que algún término del texto original se encuentre ya almacenado en la base de datos terminológica con su correspondiente traducción, por lo que el traductor solo tendrá que utilizar una combinación de teclas (también en el caso de Déjà Vu, Ctrl más el número del término, que aparece indicado en la ventana de autobúsqueda, como puede verse en la parte inferior derecha de la imagen anterior).

La principal crítica que se hace a las memorias de traducción es que, si no cuentan con una gran cantidad de material almacenado, no sirven... Sin embargo, esto no es así, dado que también son útiles cuando hay que conservar el formato (como en el caso de la traducción de una página web), por ejemplo, y, además, conforme se vaya traduciendo puede ir añadiéndose material, desde memorias de traducción hasta lexicones que, más tarde, se incorporarán a la base de datos terminológica, dando lugar a una memoria de traducción muy bien alimentada y a una traducción de mejor calidad:

Resultado final del ejercicio realizado hoy en clase que
consistía en la traducción del manual de un iPad; en este
caso, por ejemplo, disponer de un buen lexicón o de una
buena base de datos terminológica es fundamental para 
conseguir una mejor traducción en cuanto al tiempo 
empleado en realizarla y en cuanto a su calidad.


__________________________
(1) Una definición más completa es la que ofrece SDL/Trados en su página web: http://www.translationzone.com/en/translation-agency-solutions/terminology-management/ [Consulta: 20/IV/2012]

miércoles, 4 de abril de 2012

La traducción automática

Creo que ha llegado el momento de hablar un poco sobre la modalidad de traducción que amenaza con quitarnos el trabajo...

A pesar de que no pretendo ser fatalista, sí que es verdad que la traducción automática mejora a pasos agigantados y, por ello, en cierto modo representa una amenaza para los traductores humanos. Sin embargo, todavía no es momento de alarmarse, como he demostrado en algunas entradas y como demostré en dos trabajos que realicé para la asignatura de (precisamente) Traducción Automática el año pasado. 

El traductor automático está muy lejos de sustituir al traductor humano, aunque cada vez lo hace mejor y un buen ejemplo de esto es el traductor de Google que, debido a que ha sabido aprovecharse del creciente fenómeno del crowd-sourcing (o podríamos decir que ha obtenido una gran ventaja gracias a la enorme y desinteresada aportación de muchas personas que se ofrecen para corregir las traducciones automáticas), está alcanzando una calidad sorprendente... Gracias a esto, Google va a volver a consolidarse como gigante, parece ser.

Volviendo al tema que nos ocupa, como ya he dicho, me gustaría hablar brevemente sobre la traducción automática. ¿En qué consiste? ¿Por qué es tan importante? ¿Tiene que ver con los temas de los que he estado hablando desde que empecé a escribir el blog? ¿Debemos sentirnos amenazados por la traducción automática? Me voy a tomar la licencia de utilizar los trabajos que presenté para la asignatura de Traducción Automática (que para eso son míos...); sin embargo, como no están publicados en ningún sitio (es lo que tiene carecer de prestigio en el mundillo), tendréis que fiaros de lo que os cuento.

¿En qué consiste la traducción automática?

La traducción automática se incluye dentro de la disciplina de la Lingüística Computacional que, a su vez, se incluye en el Procesamiento del Lenguaje Natural (que se engloba dentro de la Inteligencia Artificial). El proceso no tiene mayor misterio (¡en teoría!): se le ofrece un texto en una lengua al programa y este lo traduce, siempre que la lengua de origen o de llegada se incluya entre sus «lenguas de trabajo», claro.

Ahora bien, los resultados de este tipo de programas dejan mucho que desear y por ello es bien conocido Google Translate (de él hablé, por ejemplo, a propósito de la posedición en las traducciones automáticas); sin embargo, sus resultados son cada vez mejores...

Sin embargo, también existen programas más específicos de traducción automática; en mi caso, analicé para esos trabajos el programa Systran, que combina dos tipos de traducción automática, la directa (es decir, palabra por palabra; el programa utiliza un conocimiento más de tipo morfológico) y la de transferencia (el programa utiliza un conocimiento lingüístico comparativo entre las dos lenguas, la origen y la meta y, a partir de este, realiza un análisis sintáctico mediante árbol); no utiliza, sin embargo, la de interlingua, en la que lo importante es la idea, el significado (en este tipo de traducción automática, se traduce el texto origen a lo que significa y, a partir de ese significado, genera el texto meta). Como veis, he aprovechado este párrafo para incluir algunos conocimientos básicos sobre la traducción automática...
Captura de pantalla del programa Systran. Extraído de
http://www.translationsoftware4u.com/systran-standard.php
Las conclusiones que saqué de este programa fueron que, en definitiva, las calidades de las traducciones hechas por programas de traducción automática son aceptables, pero... podrían mejorarse muchísimo, no solo desde el punto de vista estilístico (el más complicado de todos para cualquier programa informático), sino también desde los otros puntos de vista (léxico, morfológico, sintáctico...).

A propósito de los resultados de las traducciones automáticas, me gustaría añadir el concepto de tradautomaticidad, que sería, a grandes rasgos, la «aparición en un texto de rasgos lingüísticos que indican al receptor que es una traducción y que no ha sido realizada por un ser humano»(1); ¿cuántas veces hemos dicho que una determinada traducción parece haber sido hecha por el traductor de Google, de lo mala que es? Pues ahí está esa tradautomaticidad...

Para intentar solucionar los problemas de la traducción automática (y, en concreto, para intentar mejorar sus resultados), centré el segundo trabajo de dicha asignatura en el problema de las multipalabras, combinaciones léxicas de una o más palabras que suelen dar bastantes quebraderos de cabeza al traductor automático, puesto que, muchas veces, lo peor que puede hacerse es traducirlas literalmente, es decir, palabra por palabra. Recuerdo que en el trabajo ponía el ejemplo, entre otros, de la traducción al inglés de Pedirle peras al olmo, To get blood out of a stone... Nada que ver, como veréis.

¿Qué debe hacer el programa de traducción automática en estos casos? Pero ¿es acaso consciente de que se tratan de multipalabras? En la mayoría de los casos, no, por lo que las traduce de forma automática y problema solucionado. No quiero entretenerme con los análisis que realicé (ni tampoco os recomiendo que leáis el trabajo, porque, primero, es bastante extenso y, segundo y sobre todo, no está publicado, repito, en ninguna parte), pero sí que es verdad que, al echar la vista atrás, me he sorprendido de todas las propuestas de las que hablé en su momento, incluido un análisis tomando como punto de partida la lengua japonesa y las ambigüedades a las que se enfrenta el traductor automático... (Si, en ocasiones, nosotros mismos no sabemos qué quiere decir el autor del original, ¿cómo va a saberlo el traductor automático?)

¿Por qué es tan importante la traducción automática?

Creo que, después de todo lo que he dicho, poco más se puede añadir... Sí que es verdad que los programas de traducción automática nos ayudan cada vez más en la traducción de textos aunque, como con todo, hay que tener cuidado y no depender totalmente de ellos, y que solo sirvan de ayuda (por cierto, se trata de la misma conclusión a la que llegué a propósito de las memorias de traducción), es decir, que sean una herramienta más para el traductor, para ayudarle a ser más eficaz y a que la calidad de sus traducciones sea mucho mejor. En definitiva, más que la traducción automática, sería mejor utilizar las memorias de traducción, pero no me detendré más en esa parte. 

De todas formas, la traducción automática resulta muy útil a la hora de traducir textos repetitivos o sencillos, es decir, más objetivos, como podrían ser los textos especializados (y nada de usarla, por supuesto, para la traducción literaria...). También sirve como una primera aproximación a un texto, conozcamos o no la lengua de origen (y si no la conocemos, resulta muy útil).

Y... ¿esto tiene que ver con las entradas anteriores?

Creo que, a estas alturas (del blog y de la entrada, me refiero), no hay mucho más que añadir... Y la pregunta se responde por sí sola: sí, todo esto tiene que ver con la informática aplicada a la traducción, dado que, a la larga, todas estas utilidades, programas, herramientas, aplicaciones, consejos, comentarios, reflexiones... sirven para que nuestro trabajo mejore y para que sea más rápido... y para poder sobrevivir en el actual mercado laboral, claro, en el que te exigen saber de casi todo (por no decir de todo).

¿Debemos sentirnos amenazados por la traducción automática?

Tampoco me queda mucho que comentar con respecto a esto: no, todavía no supone una amenaza, aunque habrá que volver a hacerse esta pregunta dentro de unos diez años (o menos, dado el ritmo al que va todo). No es una amenaza, sino que es una ayuda, no es un enemigo, sino que, como ya dije en su momento a propósito de las memorias de traducción, puede convertirse en un compañero de viaje.

Para terminar, y a modo de conclusión, os dejo una cita de Cristóbal Cáceres Rodríguez que, a mi parecer, resume bastante bien el estado de la cuestión de la traducción automática:

Los traductores automáticos, en suma, se encuentran aún muy lejos de sustituir al traductor humano. Quizás se deberían llamar más que traductores, con propiedad, gestores de léxico o algo por el estilo, porque el producto final que nos ofrecen está muy lejos de lo que se entiende, en su teoría, por una traducción. Sin duda, son un buen auxiliar que resuelve situaciones de escasa importancia o agilizan el trabajo de comprensión ante un texto de otra lengua. Sin embargo, a las limitaciones inherentes a todo diccionario, que son su punto de partida, hay que añadir las de poseer una mayor o menor capacidad de almacenaje y  gestión de la información y la de tenerse que mover siempre en los límites de lo inventariable y computable; son, en suma, incapaces de interpretar, de comprender y esto es particularmente perceptible en aquellos usos del lenguaje en los que predominan valores de individualización; el lenguaje poético, en el que predomina la función estética, puede ser un buen ejemplo [...]; el uso consciente de valores connotativos hace prácticamente imposible la traducción automática de un poema.(2)

____________________________
(1)Moré López, Joaquim, Climent Roca, Salvador: «La tradautomaticidad, un concepto aplicado a la evaluación de sistemas de traducción automática» en Procesamiento del lenguaje natural, n.º 37, 2006, p. 234.
(2)Cáceres Rodríguez, Cristóbal : «Connotaciones y traducción automática» en Cien años de investigación semántica, de Michel Breal a la actualidad: actas del congreso Internacional de Semántica, vol. 2, 2000, p. 1275.